一文解决社区常见问题 · 第 1 期 | 数组向量从入门到避坑

做量化的朋友,大概都见过这样的行情表。

股票十档、期货五档,光买卖盘口就有 40 个字段。建表冗长,因子计算要逐档取列,压缩率也上不去。
DolphinDB 为此专门设计了一种数据结构,叫数组向量(Array Vector)。行情里的多档买卖价、买卖量,各存成一个数组向量列,40 个字段就能收成四列。
数组向量作为一种新的数据类型,在实际使用中会涉及建表、写入、查询等多个环节。我们从社区反馈中梳理出一批较为典型的使用场景,覆盖从建表到数据导入的全流程,帮助大家更顺畅地上手数组向量。
一、什么是数组向量
数组向量是一种特殊的向量类型,用来存可变长度的二维数组。它和矩阵类似都用于存储为二维的数据结构,和矩阵要求每行等长不同,数组向量的每行可以存储不同长度的一维向量。
三种创建方式
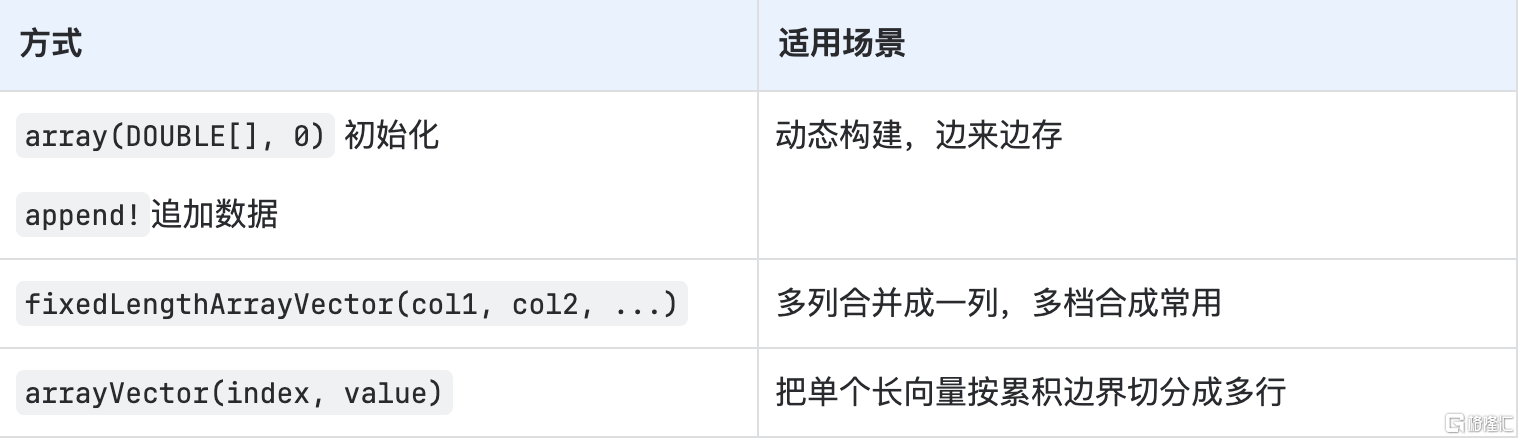
bid = array(DOUBLE[ ], 0)
bid.append!([[3.3, 3.6, 3.8], [3.7, 3.4], [3.5]])
// bid
// [[3.3,3.6,3.8],[3.7,3.4],[3.5]]
上面这个 bid 有三行,第三行只有 2 个元素。变长是数组向量的天然属性,停牌、档位缺失的时候不用补齐,这正适合多档行情。
数组向量是什么、怎么创建,都弄清楚了。接下来看实际场景中经常碰到的报错,第一次用就很容易撞上。
二、建表与写入,两个摸不着头脑的报错
问题 1,schema 里写 DOUBLE[],一写就报语法错误
有人贴过一段定义,一跑就是语法错误。
colTypes = [`SYMBOL, `INT, `DOUBLE[], `LONG[ ]]
问题出在反引号上。backtick 符号向量里,[] 会被解析器当成下标 token,DOUBLE[] 自然不成立。
正确写法有两种。要么直接用类型保留字,要么使用双引号或者单引号。
colNames = `sid`date`bid`ask
colTypes = [SYMBOL, DATE, DOUBLE[], DOUBLE[ ]]
// 方式一:类型保留字
t = table(100:0, colNames, colTypes)
// 方式二:字符串类型向量
t = table(100:0, `sid`date`bid`ask, ["SYMBOL","DATE","DOUBLE[]","DOUBLE[ ]"])
问题 2,向流表 insert 含数组向量的行,一直报类型错误
群里有人往 stream_tick 里插一行,只要带数组向量列就报类型错误。他的流表里有四列数组向量,askPrice、bidPrice 是 DOUBLE[],askVol、bidVol 是 INT[]。当时的写法是这样,末尾四列直接以向量形式传了进去。
insert into stream_tick values (1775201379000, "000001.SZ", 10.50, 10.55,
10.60, 10.45, 10.48, 25600000, 24412, 244120, 5, 15, 0, 10.48,
[10.51, 10.52, 10.53, 10.54, 10.55], // askPrice 五档
[10.50, 10.49, 10.48, 10.47, 10.46], // bidPrice 五档
[10, 20, 30, 40, 50], [50, 40, 30, 20, 10]) // askVol, bidV
问题就出在末尾四列。数组向量列的值,得先用 array 函数构建成数组向量,直接以列表形式传进去,类型对不上。
insert into stream_tick values (1775201379000, "000001.SZ", 10.50, 10.55,
10.60, 10.45, 10.48,
25600000, 24412, 244120, 5, 15, 0, 10.48,
array(DOUBLE[]).append!([[10.51, 10.52, 10.53, 10.54, 10.55]]),
array(DOUBLE[]).append!([[10.50, 10.49, 10.48, 10.47, 10.46]]),
array(INT[]).append!([[10, 20, 30, 40, 50]]),
array(INT[]).append!([[50, 40, 30, 20, 10]]))
用 array 函数包一层,这行数据就能正常插进去了。
三、数据导入,CSV 的两个经典问题
问题 1,CSV 里十档是 10 个独立列,怎么合并成 1 列
有人问,CSV 里 bid1 到 bid10 是 10 列,想导入后变成 1 列 DOUBLE[]。
官方给了两种方式。方式一,导入前先把多列合并成一列,用特定分隔符(比如 |)隔开,再通过 arrayDelimiter 识别。
// 源 CSV 中盘口为单列,其余列按实际类型补充
bid
1.4799|1.479|1.4787|1.4796|1.479
t = loadText("./snap.csv",
schema=table(`id`bid as name, ["INT", "DOUBLE[]"] as type),
arrayDelimiter="|")
方式二,在 loadTextEx 的 transform 里合并,多列已经在表里时用。
def trans(mutable t){
return select *,
fixedLengthArrayVector(bid1, bid2, bid3, bid4, bid5,
bid6, bid7, bid8, bid9, bid10) as bid
from t
}
loadTextEx(dbHandle=db, tableName="snap", partitionColumns=`TradeTime`SecurityID,
filename=csvPath, transform=trans)
问题 2,CSV 一列是 [8.76, 0.0, ...] 文本,导入后整列变空
又有人碰到一个,CSV 里一列文本形如 [8.76, 0.0, ...],用 transform 加 fixedLengthArrayVector 转换,结果目标列整列都是空值。
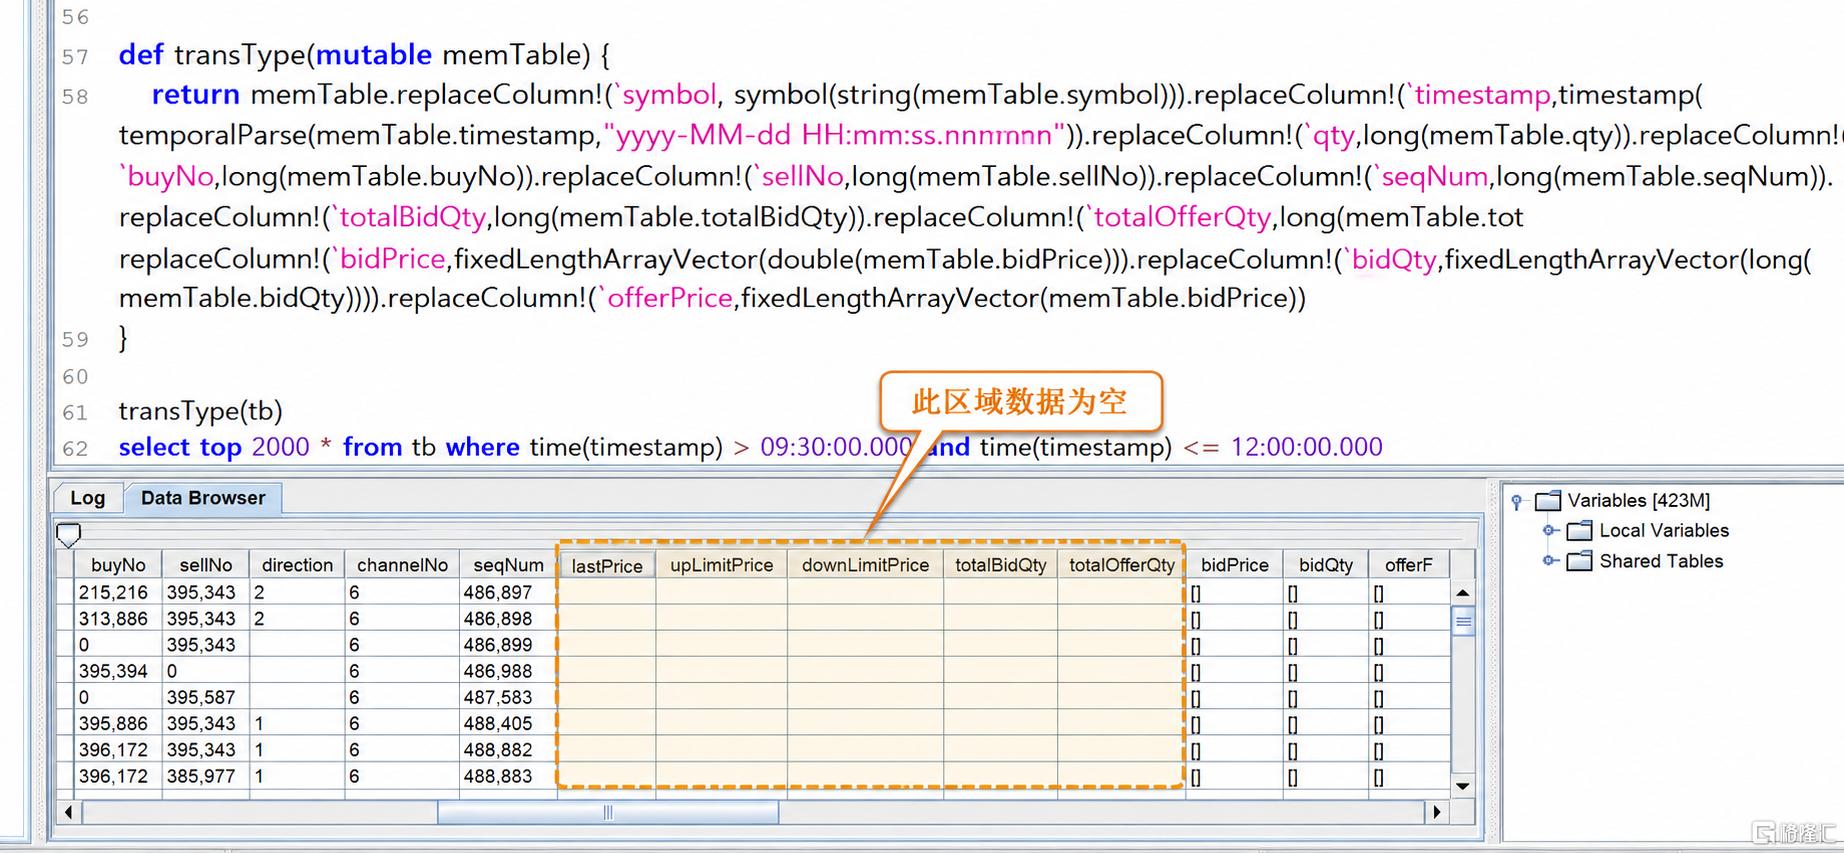 原因出在存储格式上。CSV 里数组向量列的标准格式,是值之间用分隔符隔开,
saveText 导出出来就是 1,3,5 这种,不带中括号。而这份 CSV 的盘口列是带中括号的文本,loadText 默认不认,被识别成了 STRING。
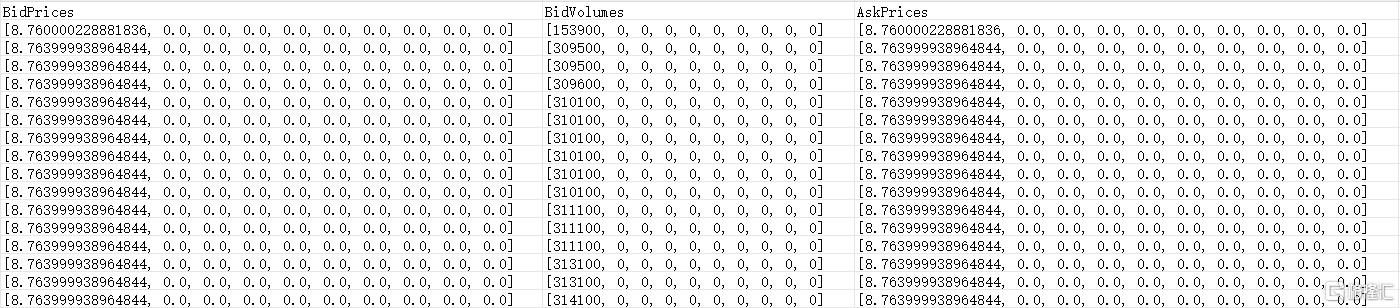 正确做法是导入时就声明成数组向量:用
extractTextSchema 取 schema,把目标列类型改成 DOUBLE[],加载时指定 arrayDelimiter 和 arrayMarker。arrayMarker="[]" 就是告诉 loadText,方括号是数组的标记,按 arrayDelimiter 切分就行,不需要去括号。
schema = extractTextSchema("./snap.csv")
update schema set type = "DOUBLE[]" where name = "bid"
t = loadText("./snap.csv", schema=schema, arrayDelimiter=",", arrayMarker="[ ]")
如果用了 transform,导入后整表变空,优先检查 transform 返回表的列名和类型是否和目标表一致。入库表结构以 transform 返回的表为准,出错时往往不止目标列,连没操作的列也会变空,这一处最容易遇到问题。
四、期货五档怎么存、怎么算
最后,社区里还有人问,期货 5 档数据怎么存储、怎么查询,需要什么方案或者插件。
答案是都不用。DolphinDB 原生支持,多档数据存成数组向量,实时行情用 CTP 这类行情插件接进来就行。
建表时,数组向量列的类型声明用字符串。
name = `SecurityID`TradeTime`BidPrice`BidOrderQty`OfferPrice`OfferOrderQty
type = ["SYMBOL", "TIMESTAMP", "DOUBLE[]", "INT[]", "DOUBLE[]", "INT[]"]
snap = table(1:0, name, type)
存储包含数组向量类型的分布式表时,必须指定引擎的类型为 TSDB。且数组向量列不能作为分区字段或排序字段。
查询和运算,基本都是对着列式索引和二元运算写。
bidPrice[0] // 买一价,每行第 1 档
offerPrice[0] - bidPrice[0] // 买卖价差
bidPrice + 1 // 每档都加 1,和标量直接运算
rowSum(bidPrice) // 逐行求和,row 系列函数
这些写法在 SQL 里可以直接用,查档位、算价差、筛条件都不在话下。
select SecurityID, TradeTime,
BidPrice[0] as bid1, // 买一价,列式索引
OfferPrice[0] - BidPrice[0] as spread, // 买卖价差,二元运算
rowSum(BidOrderQty) as totalBidQty // 十档买量合计,row 系列函数
from snap
where BidPrice[0] > 10 // 直接按档位筛行
十档买卖价 40 个字段收敛成 4 列,建表成本和因子计算代码量都降了一大截。
五、欢迎使用
这几个坑绕开以后,数组向量基本就能顺手用了。以后再碰到,按下面三步走。
先问 DolphinMind,函数签名、官方示例、报错 RefId,直接检索官方文档
复杂场景交给 DolphinX,因子计算、回测、研报复现这些任务让 Agent 去跑
搞不定就来社区群 @我们,或者在 ask 社区提问,欢迎大家在 DolphinDB 生态社区积极讨论、共同成长
格隆汇声明:文中观点均来自原作者,不代表格隆汇观点及立场。特别提醒,投资决策需建立在独立思考之上,本文内容仅供参考,不作为实际操作建议,交易风险自担。